本文仅用于个人学习与技术研究,不涉及任何商业目的。目标软件为闭源系统,本文分析仅为静态学习,未进行任何侵权或破解行为。作者不承担任何使用后果。
继续上次的逆向。
main函数相对来说比较简短,不过大部分库函数我还是不认识,仅能凭借名字的英文缩写,随便找了一个看起来最熟悉的:j_DEVDB_LoadDevSo函数,dev一般指设备,db可能是数据库,load是加载,结合起来,大概可以推测它可能跟驱动/硬件的存储信息有关。
确定切入点后,就尝试查找它在哪个库里被实现,而vrp所依赖的so都在/mnt/squash/lib目录下。
grep -r会把所有的库全部查询一边,并且还会引入很多无关信息,于是,我干脆写了一个脚本,并对它进行了简单的交互式处理以便以后的复用。
libseekstr
此部分如果不感兴趣可跳过
#!/bin/sh
TARGET=$1
TARGET_RPATH=$2
RED='\033[0;91m'
GREEN='\033[0;92m'
YELLOW='\033[0;93m'

usage()
{
    echo "usage: libseekstr <target> <rpath>"
    echo "---target: the elf file to be analysed."
    echo "---rpath: the lib directory for the elf file."
    echo ""
    echo "Input 'q' or 'quit' to exit."
    echo "Tips: strings length is set to 3."
    exit 1
}

if [ $# -ne 2 ]
then
    usage
    exit 1
elif [ ! -f "$TARGET" ]
then
    echo "${RED}[!] Not found: ${TARGET}."
    exit 1
elif [ ! -d "$TARGET_RPATH" ]
then
    echo "${RED}[!] Not found: ${TARGET_RPATH}."
    exit 1
fi

TARGET_RPATH=${TARGET_RPATH%%/}

while true
do
    echo "${YELLOW}[+] Now handling with ${TARGET}."
    printf "${YELLOW}[+] Please input the string you want to search>"
    read -r str
    if [ -z "$str" ]
    then
        echo "${RED}[!] Need a str."
        continue
    fi
    case "$str" in
    "quit")
        echo "${GREEN}[+] EXIT."
        exit 0
        ;;
    "q")
        echo "${GREEN}[+] EXIT."
        exit 0
        ;;
    esac
    strings -n 3 "$TARGET" 2>/dev/null | grep -F "$str" | while read -r tmp_line
    do
        echo "${GREEN}[-] $tmp_line FROM $TARGET"
    done
    readelf -d "$TARGET" 2>/dev/null | grep NEEDED | awk -F'[' '{print $2}' | awk -F']' '{print $1}' | while read -r line
    do
        strings -n 3 "$TARGET_RPATH/$line" 2>/dev/null | grep -F "$str" | while read -r tmp_line
        do
            echo "${GREEN}[-] $tmp_line FROM ${TARGET_RPATH}/${line}."
        done
    done
done
实现了一个简单的交互式工具(因为遇到需要多次查询的情况,反复敲路径真的很费劲),通过读取命令行固定位置的target和rpath,对当前目录下的target文件执行readelf并解析NEEDED字段,然后去rpath路径下对所有NEEDED字段出现过的so以及target文件本身执行strings -n 3 查询str,并返回成功信息,同时屏蔽了readelf的报错
适合:
- [Y] /lib下有好几百个库的情况,可以大大加快速度,避免grep -r跑飞的问题
- [Y] 需要反复查询字符串,硬编码,特征字符串的场景
避免:
- [N] 多个库之间有互相依赖关系(因为不是递归解析,只会查询target文件直接NEEDED的so文件)
- [N] target文件来源于不同的文件夹(当然你可以新建一个文件夹并把所有库放在一起)
经过查询,该函数出现在libdevdb.so当中,经过简单的符号重命名,其伪代码大概是这样(python demo替代):
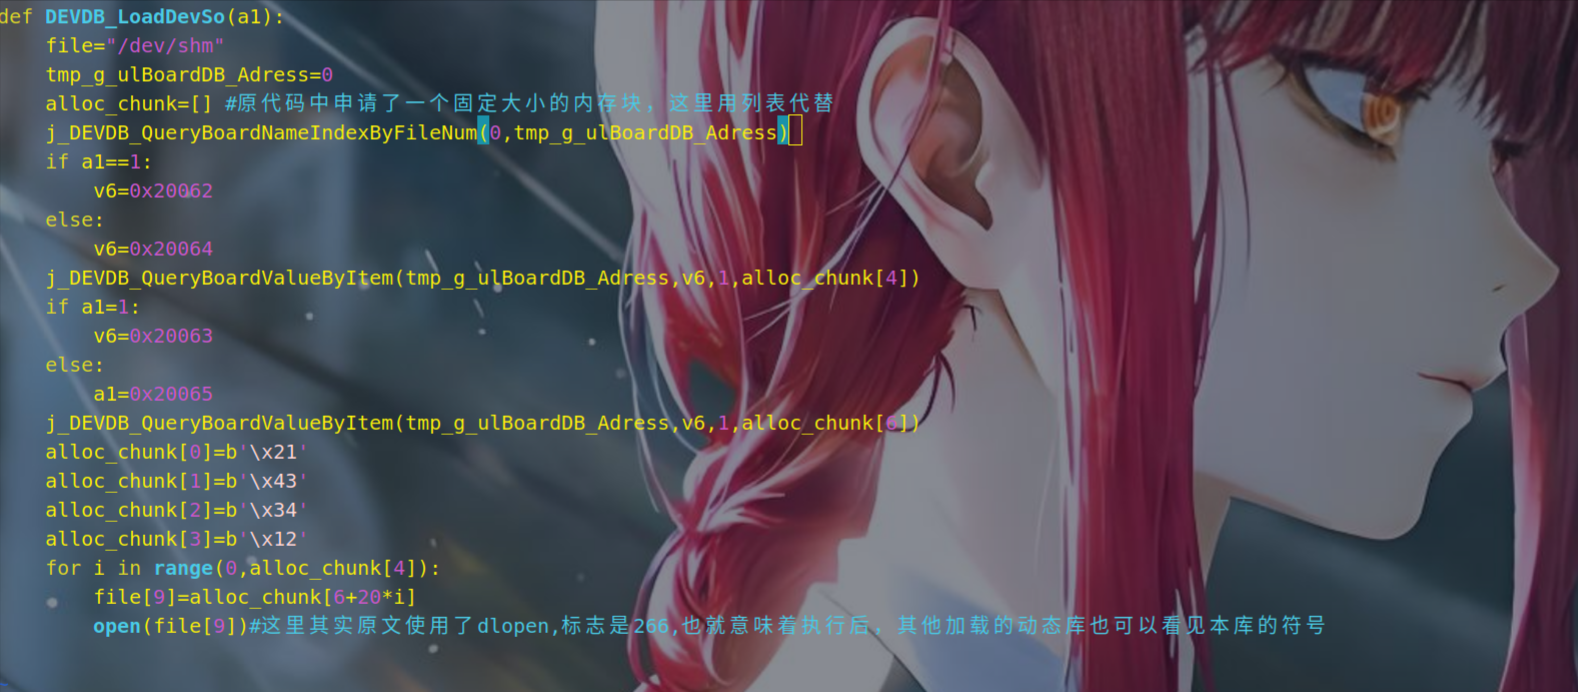
于是进一步追踪,逆向它内部出现的j_DEVDB_QueryBoardNameIndexByFileNum函数:

观察到有一个名为g_ulBoardDB_Adress的变量,对它进行交叉引用后,发现它是在DEVDB_LoadDB函数中被赋值,恰好,在vrp的主函数中,它同样出现过,并且比j_DEVDB_LoadDevSo出现时间更早:
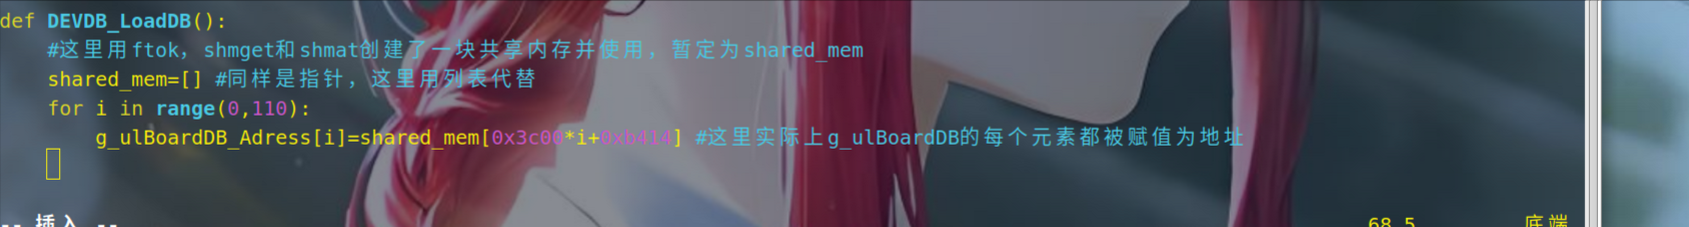
该函数首先调用了ftok,针对/mnt/db生成了一个key值,随后调用shmget处理key,返回一个shared_id>,并借助它访问了shared_id对应的共享内存,定义一个变量g_ulDevDBSharedAddress,赋值为该段内>存的基地址,在这个基地址的基础上加0xB414,作为g_ulBoardDB_Adress[i]数组的起始地址,用
    for(i = 0;i <= 109; ++i)
    {
            g_ulBoardDB_Adress[i] = g_ulDevDBSharedAddress + 0x3C00 * i + 0xB414
    }
实现对g_ulBoardDB_Adress[i]的赋值,这里我们可以猜测出,应该有110个名为ulBoardDB的对象,每>个占据0x3c00字节大小的内存空间。
于是,我们知道,DEVDB_LoadDB函数中,将共享内存中的一段连续内存进行了按0x3c00大小进行了划分。
DEVDB_LoadDevSo函数中,另一个关键函数是DEVDB_QueryBoardValueByItem,此函数有大量的结构体赋值操作,不便用python demo表达,因此这里简述其实现:
该函数执行一个循环,根据g_ulBoardFileNum来决定循环次数;
它先对g_ulBoardDB_Adress做了校验,确定它与当前的tmp_g_ulBoardDB_Adress相匹配;
随后,它访问g_ulBoardDB_Adress[i]+4这一地址,从其中读取了一个数据,这里将它暂命名为count;
随后,再次执行循环,循环次数为count,是从g_ulBoardDB_Adress[i]+8这一地址开始,以每16个字节为一>个单位每个单位包含四个属性,分别对应offset_0,offset_4,offset_8,offset_12;
offset_0,offset_4分别存入v13,v17,接下来对v13和v17做判断,如果v13 == v6(0x20062),并且v17 == 1,就将offset_8存进v16,offset_12存进v11,最后以v16的大小,将g_ulBoardDB_Adress[i]+v11复制进提前准备好的,malloc的内存中。
于是可以修复两个结构体:
uk_element
{
        DWORD _v6
        DWORD flag
        DWORD size
        DWORD addr_offset
}
以及
ulBoardDB
{
        void * base_addr
        int count
        struct uk_element elements[10] (这里10是随便取的值,因为这个ulBoardDB无法被0x3c00-8整除,所以
它可能还含有其他结构)
        char padding[n]
}
总结一下,这一段的流程大概就是:
j_DEVDB_LoadDB制造一段共享内存,并把这段共享内存拆成前后两部分,后半部分又被拆成数个0x3c00大小的ulBoardDB对象;
而在DEVDB_LoadDevSo函数中,它malloc出一小块内存,然后调用j_DEVDB_QueryBoardNameIndexByFileNum和j_DEVDB_QueryBoardValueByItem,j_DEVDB_QueryBoardValueByItem对之前DEVDB_LoadDB制造出的共享内存的某个ulBoardDB对象进行头部解析,获取该对象里的element的数量,并即刻对它进行for循环暴力查找,找到element数组中第一个属性等于v6的元素,并精确地返回它在共享内存中的地址。
显然,它们之间还缺了一步:这个共享内存被创建以后,还需要一次赋值/加载,才能执行DEVDB_LoadDevSo的查询逻辑。
而在main函数中,DEVDB_LoadDevSo和j_DEVDB_LoadDB之间确实还有一个名为MON_LoadRecordReasonModules的函数,下次将对它展开深入研究。